我是詹佳博(Jiabo Zhan),现为清华大学深圳国际研究生院计算机技术硕士研究生,导师为袁春教授。我于 2026 年获得北京航空航天大学软件工程学士学位,本科期间以 GPA 3.873/4.0、专业排名 2/172(前 1.2%)毕业。
我的研究方向为计算机视觉、多模态大模型(MLLM)与强化学习,近期工作聚焦透明感知 RGBA 图像生成与编辑、鲁棒文档解析,以及工具增强视觉问答。目前在腾讯微信事业群(WXG)技术架构部担任算法实习生,主要从事多模态训练数据建设、监督微调与评测。

🔥 最新动态
- 2026.09: 进入清华大学深圳国际研究生院攻读计算机技术硕士学位,导师为袁春教授。
- 2026.09: WeVisDoc 技术报告发布,面向鲁棒端到端文档解析,代码与 2B/4B 模型权重已开源。
- 2026.08: PaDoc 正式发布,代码与模型权重已开源。
- 2026.08: 🎉 OmniAlpha 被 ACM Multimedia 2026(ACM MM 2026)录用,并入选 Oral Presentation(口头报告)!
- 2026.07: 加入腾讯 WXG 技术架构部,担任算法实习生。
- 2026.04: OmniAlpha 完成重要更新,引入面向透明感知生成的多任务强化学习。
- 2025.11: OmniAlpha 正式发布,代码与模型权重已开源。
- 2025.07: AlphaVAE 正式发布,代码、数据与模型已开源。
📄 技术报告

WeVisDoc: From Coverage to Capability for Robust End-to-End Document Parsing
Hao Yu*, Kang Liu*, Linnan Zhao*, Jiabo Zhan*, Chong Sun, Chen Li, Jing Lyu
* 共同一作。技术报告,2026。
研究时间:2026.06 – 2026.09。
报告 / PDF / 项目主页 / 代码 / 模型(2B) / 模型(4B)
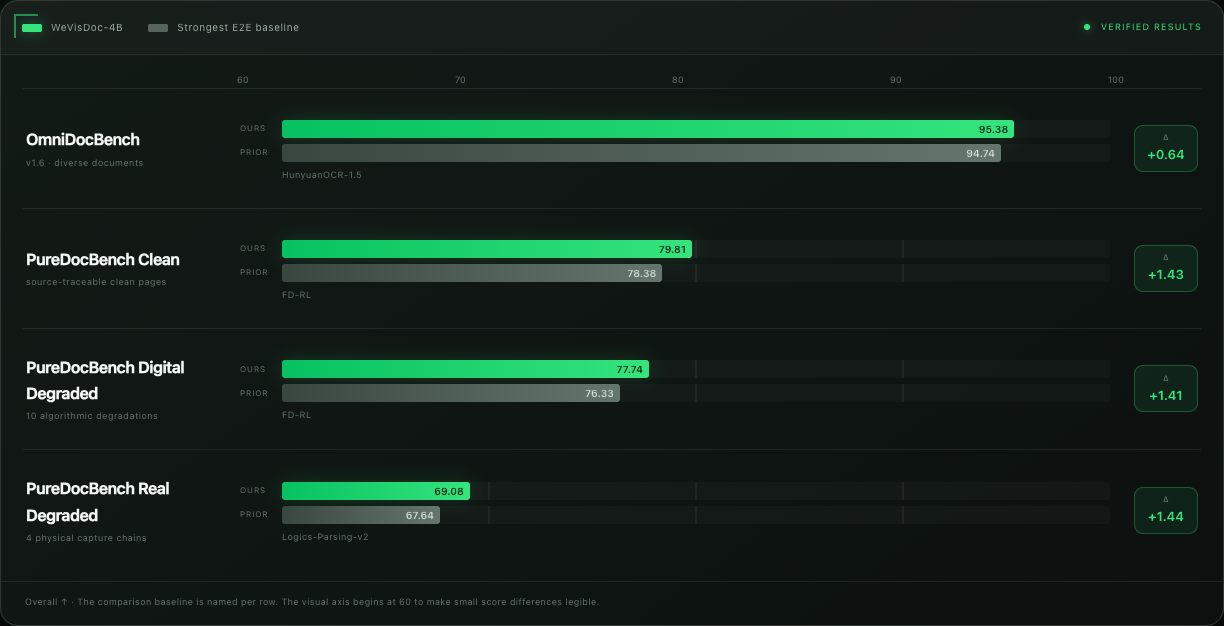
- 提出两阶段数据驱动框架:先扩展文档数据覆盖,再通过残余错误诊断指导定向数据构建与训练预算分配,提升端到端文档解析的鲁棒性。
- WeVisDoc-4B 在 OmniDocBench v1.6 上取得 95.38 的 Overall 分数,在 PureDocBench 三个赛道上的平均 Overall 分数为 75.54,在四项设置中均位列所比较的端到端解析器第一。
- 个人贡献:负责手写、试卷及教材数据采集与标注,通过爬虫采集、哈希去重及损坏和不可读样本过滤,结合 MinerU2.5-Pro、PaddleOCR-VL 候选标注、多模态大模型回看复核与人工区域重标,统一标注格式,构建高质量训练 GT。
- 构建数据退化与增强流程,覆盖褶皱、弯曲、旋转、真实场景合成与模糊模拟,在保持图像与 GT 一致、内容可读的前提下,增强模型对真实采集场景的泛化能力。
📝 论文
OmniAlpha: Aligning Transparency-Aware Generation via Multi-Task Unified Reinforcement Learning
Hao Yu*, Jinglin Wang*, Jiabo Zhan*, Rui Chen, Zile Wang, Huaisong Zhang, Hongyu Li, Xinrui Chen, Yongxian Wei, Chun Yuan
* 共同一作。ACM Multimedia 2026。 ORAL PRESENTATION
研究时间:2026.01 – 2026.04。
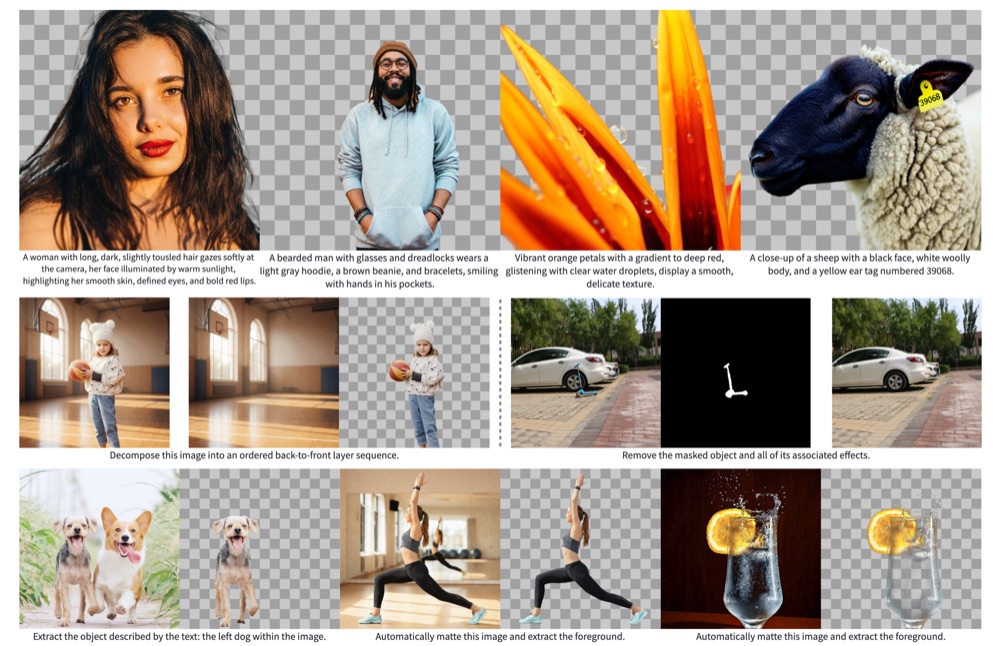
- 提出统一多任务 RGBA 生成与编辑框架,将文本生成、目标移除、自动抠图、指代抠图、图层分解五类透明感知任务整合到单一视觉基座模型中,在五类任务上均达到 SOTA 或次 SOTA 水平。
- 个人贡献:作为共同一作,主要负责多任务训练数据 schema 设计、样本构建、清洗治理与评测代码编写;参与多任务 SFT 冷启动与 GRPO 风格 RL 后训练实验,关注 reward 设计、跨任务评测与训练稳定性。
Zile Wang, Hao Yu, Jiabo Zhan, Chun Yuan
- 面向端到端 RGBA 图像重建与透明图像生成的 Alpha-aware VAE,并配套提出 ALPHA 评测基准。
- 个人贡献:完成 8,124 张高质量 RGBA 训练样本的收集、清洗与治理,并参与 benchmark、评测代码和 LoRA 数据迭代流程设计。
🎓 教育背景
研究方向:计算机视觉、多模态大模型与强化学习。
专业排名 2/172(前 1.2%),免试攻读清华大学计算机技术硕士学位。
💼 实习经历
- 围绕 WeVisDoc 文档理解,负责 Parsing/VQA 数据建设与质量治理,维护约 900 万条 VQA 数据、补充约 150 万条样本;整理手写笔记、试卷等约 3 万页长尾文档,完成去重、重标与训练数据交付。
- 构建 Direct/CoT 混合监督,开展两阶段 SFT、跨任务评测与能力偏移分析,优化不同数据源的采样配比。
- 通过教师模型生成、真实工具执行与自动审核,构建 57,132 条 Direct/工具混合 QA(Zoom/Crop、Python),完成 Qwen3-VL-4B-Instruct 工具增强 SFT;在 CharXiv-RQ 1,000 题验证集、相同 Direct 协议下,准确率从 40.6% 提升至 45.9%(+5.3 个百分点)。
- 面向压实线、超车等驾驶行为分类任务,负责输入建模、监督数据构建与 SFT 微调:对 rosbag 视频均匀采样 16 帧作为 2D 多帧输入,以人工复核的 GT 为监督信号,完成 Qwen3-VL-8B-Instruct 的 SFT 训练,构建可本地部署的开源多模态大模型分类方案。
- 模型准确率由微调前 59% 提升至 70%(+11 个百分点),Gemini 2.5 Pro 基线为 80%;将原方案约 10 美元 / 百万 token 的 API 调用成本转为本地 GPU 部署与运行成本。
🏆 奖项荣誉
- 国家奖学金:2022–2023、2023–2024 学年。
- 2022–2023、2023–2024、2024–2025 学年北京航空航天大学校级三好学生、校级优秀团员。
- 三星奖学金(2024–2025 学年);全国大学生数学竞赛北京市一等奖。
- 另获北京航空航天大学校级各类奖学金十余项。
🛠 专业技能
模型与训练
熟悉 VLM、VAE、DiT 的训练与评测流程,掌握 SFT 与 GRPO;了解 DPO、PPO 等对齐方法。
数据与评测
训练数据构建、清洗治理、benchmark 与评测代码编写、离线评测及误差分析。
多模态理解
视觉 grounding、OCR、版面分析、关键信息抽取及图像—文本—结构化信号联合建模。
工程能力
Python、PyTorch、C/C++、Java;具备多模态 pipeline 工程化与产品化落地经验。
外语能力
英语 CET-4:662 分,CET-6:633 分;具备英文论文阅读与口语交流能力。
其他经历
软件学院学生会学业中心干事;《大学英语》《编译技术》课程助教;志愿北京累计 250 小时。